IMDb
Une solution décisionnelle complète sur les données IMDb : ETL Python, entrepôt OLAP, Power BI et analyse de sentiments.
Contexte
SAE5.C.01 du BUT Informatique (2025-26, IUT d’Annecy). À partir des fichiers plats publics d’IMDb, il fallait concevoir une base SQL Server optimisée et des rapports Power BI, puis des modèles d’IA capables de qualifier une critique à partir de son seul texte, le tout sur un PC standard.
Équipe et mon rôle
Projet de groupe, 5 personnes.
J’ai pris le lead du projet et je me suis occupé de la partie technique.
Démarche
- Modélisation : MCD, MLD et MPD sous PowerAMC pour un modèle OLTP normalisé et contraint.
- ETL : script Python multithread, avec gestion manuelle de la mémoire et déchargement sur disque pour tenir sur un PC standard, puis chargement massif avec BCP.
- Optimisation : index sur les clés étrangères et index composites, justifiés par l’analyse des plans d’exécution.
- Décisionnel : passage à un modèle en étoile alimenté par SSIS, puis rapports Power BI.
- IA : TF-IDF et modèles linéaires comparés en validation croisée 3-fold, avec une grille d’hyperparamètres restreinte pour rester frugal.
Visuels
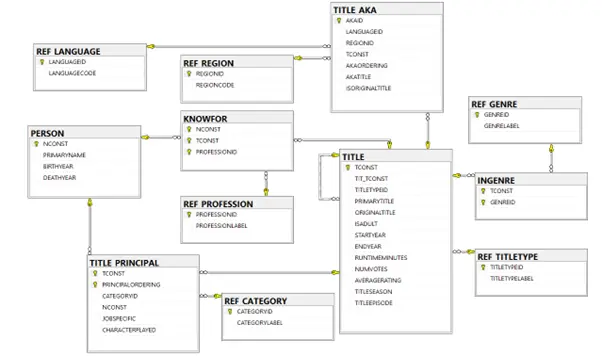
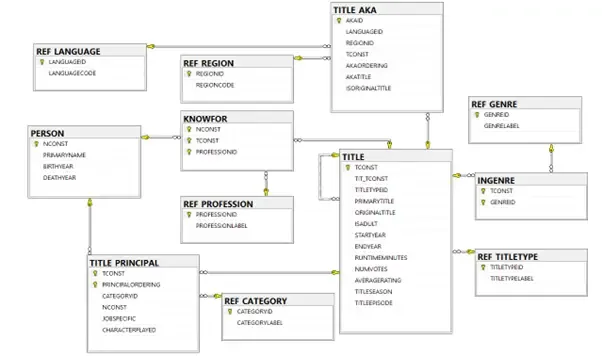
Modèle OLTP normalisé, de 12 tables. 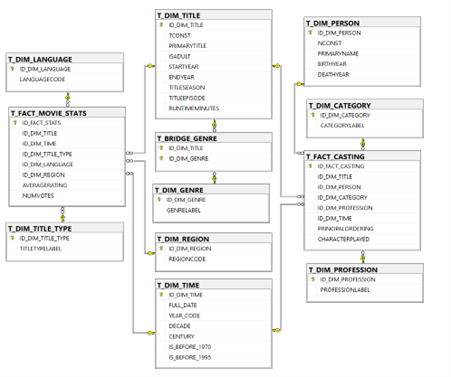
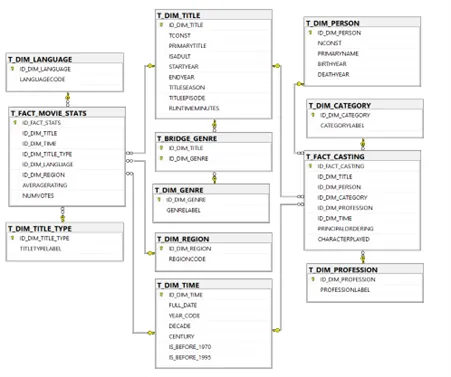
Modèle en étoile avec 2 tables de faits, 9 dimensions et une table pont pour les genres. 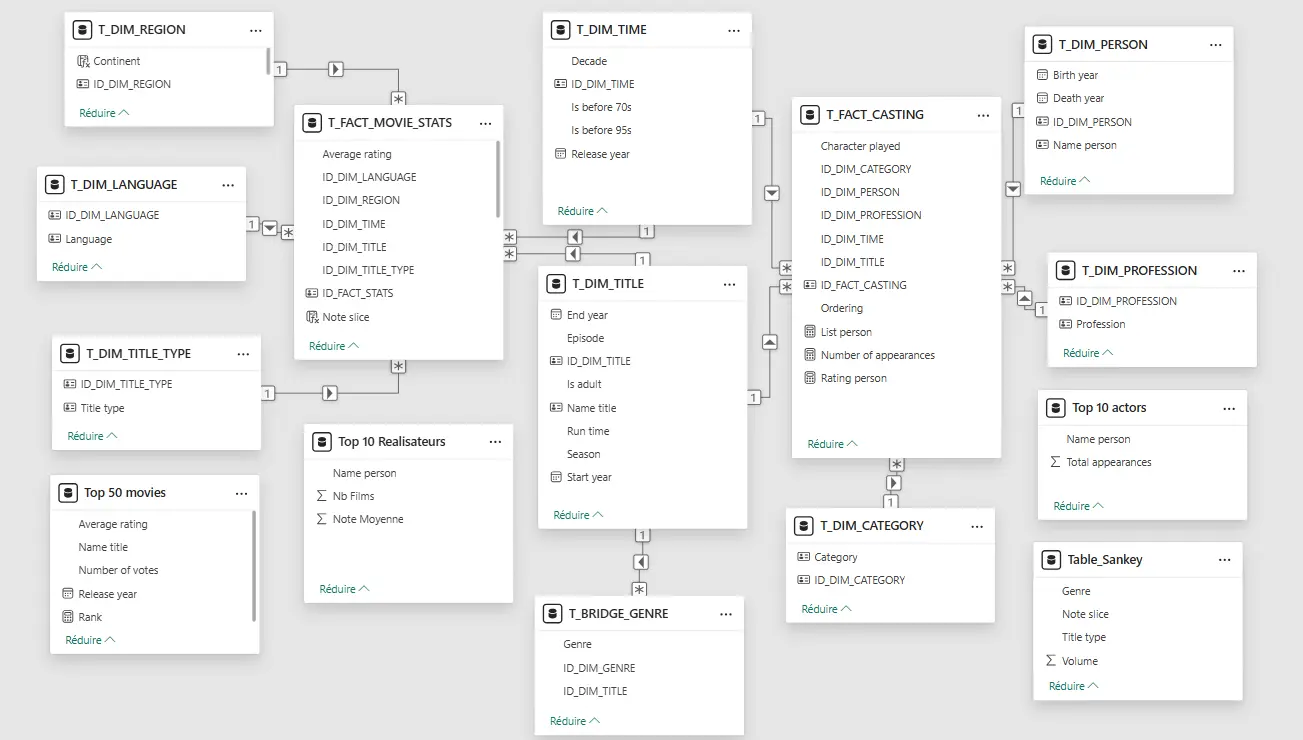
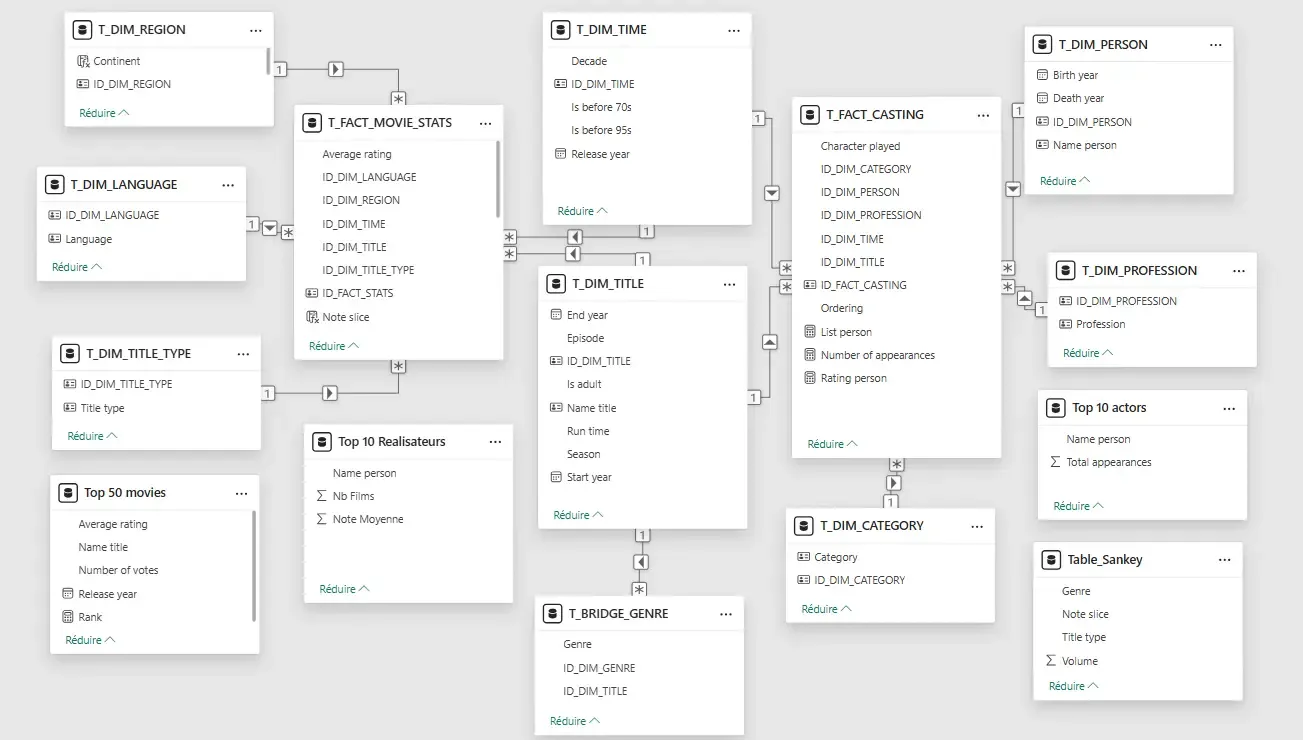
Modèle sémantique dans Power BI. 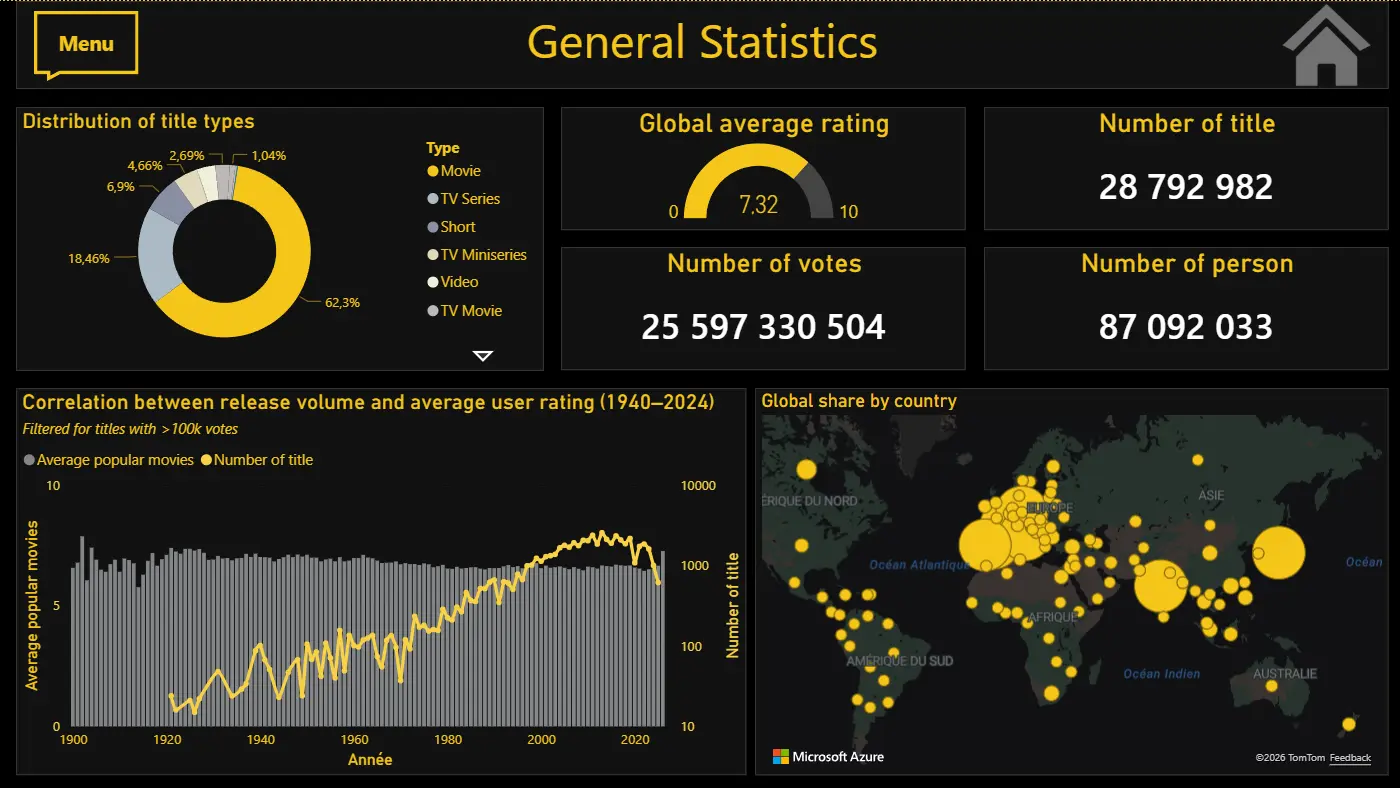
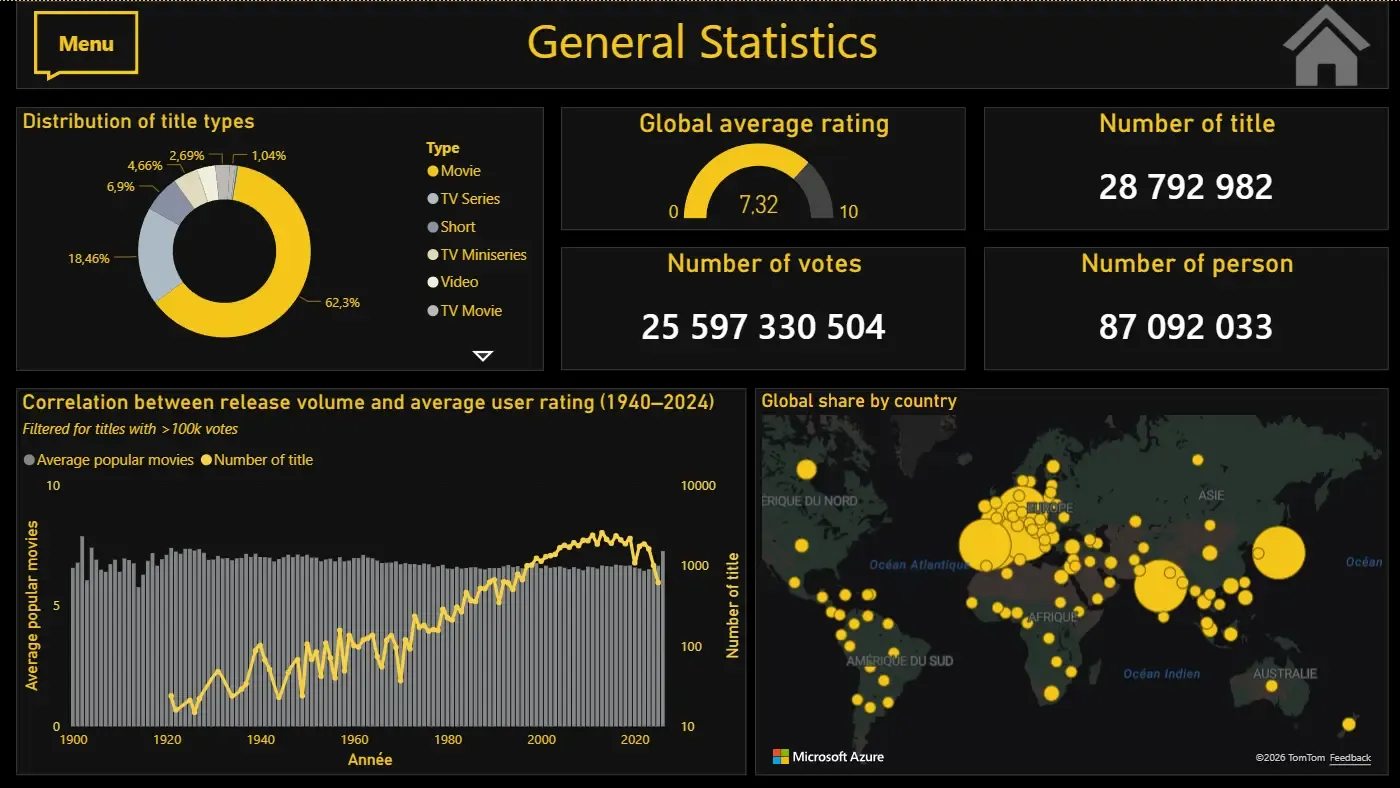
Vue d’ensemble du catalogue. 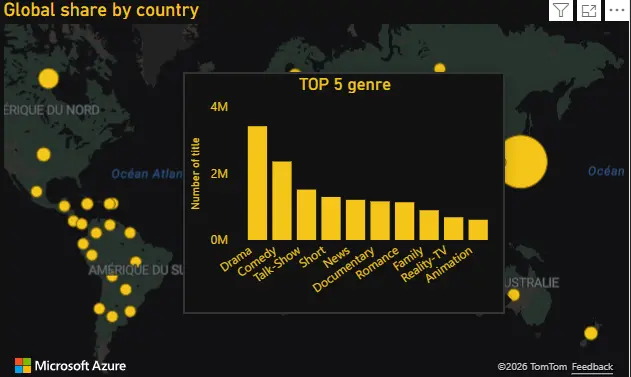
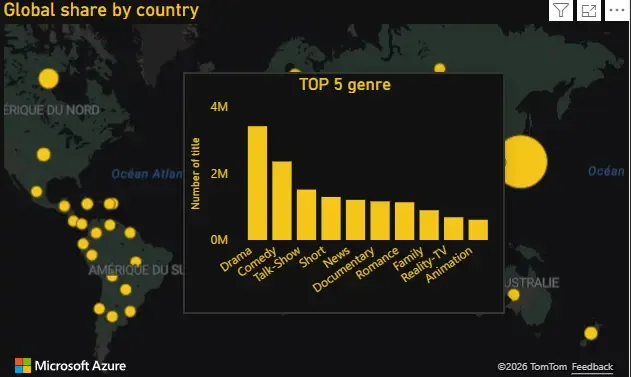
Info-bulle au survol d’un pays, avec ses genres dominants. 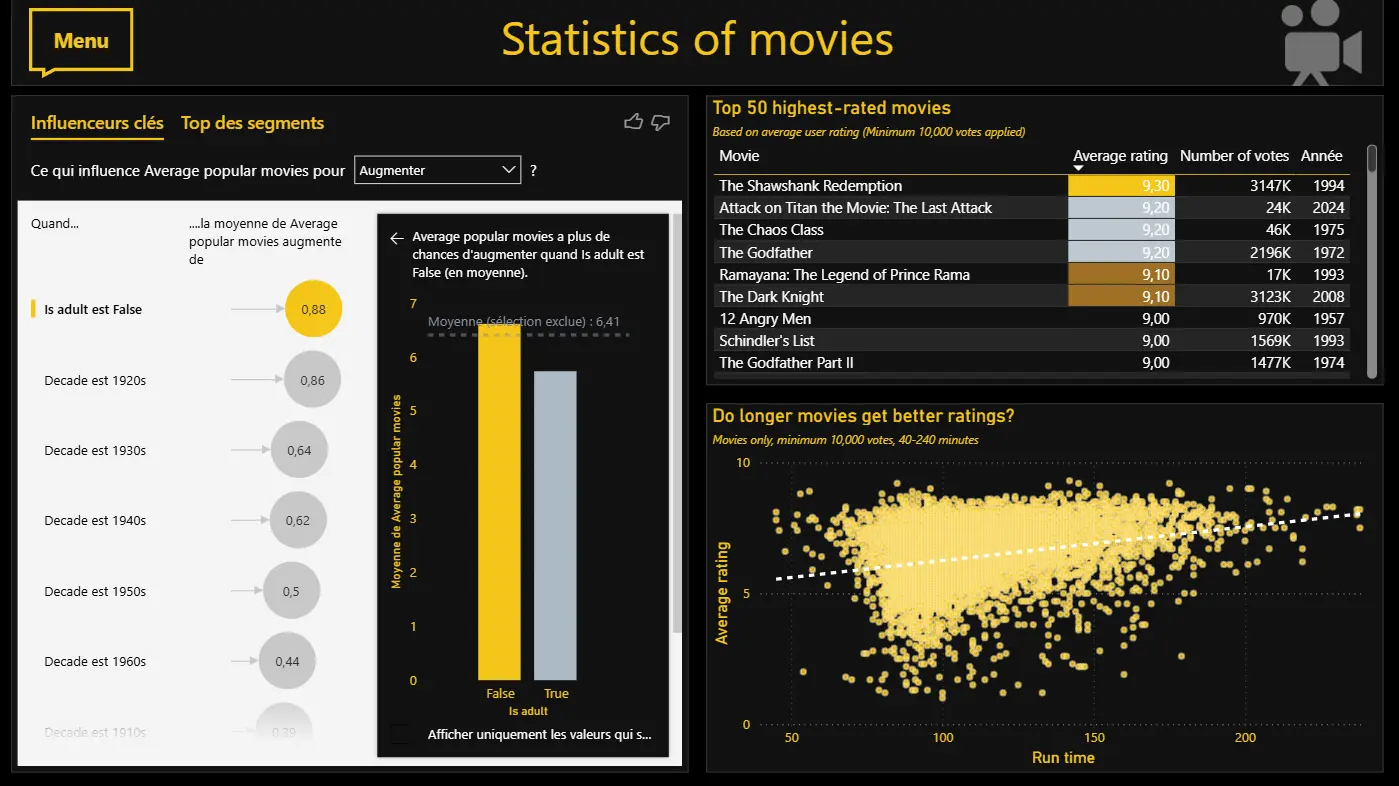
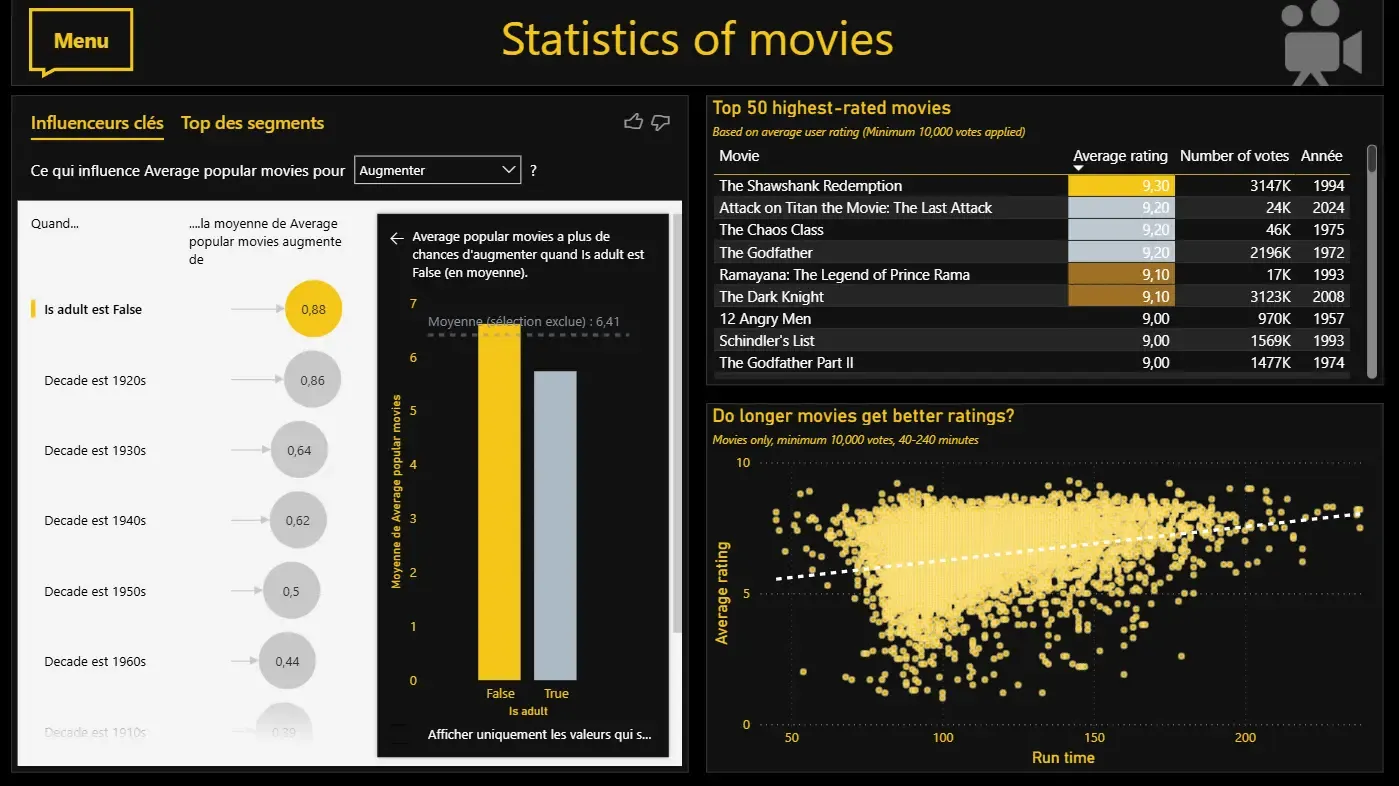
Analyse des films, avec le visuel IA « Influenceurs clés ». 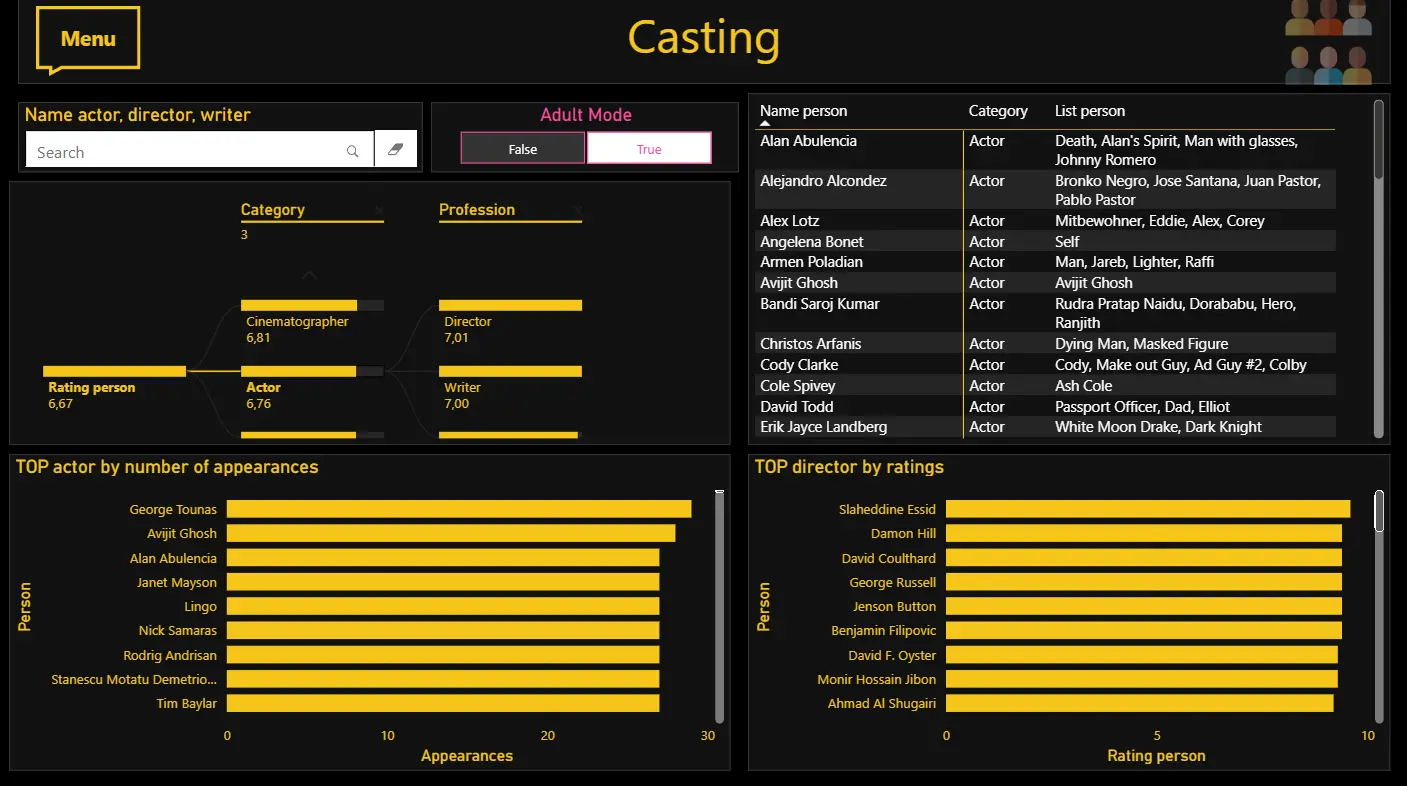
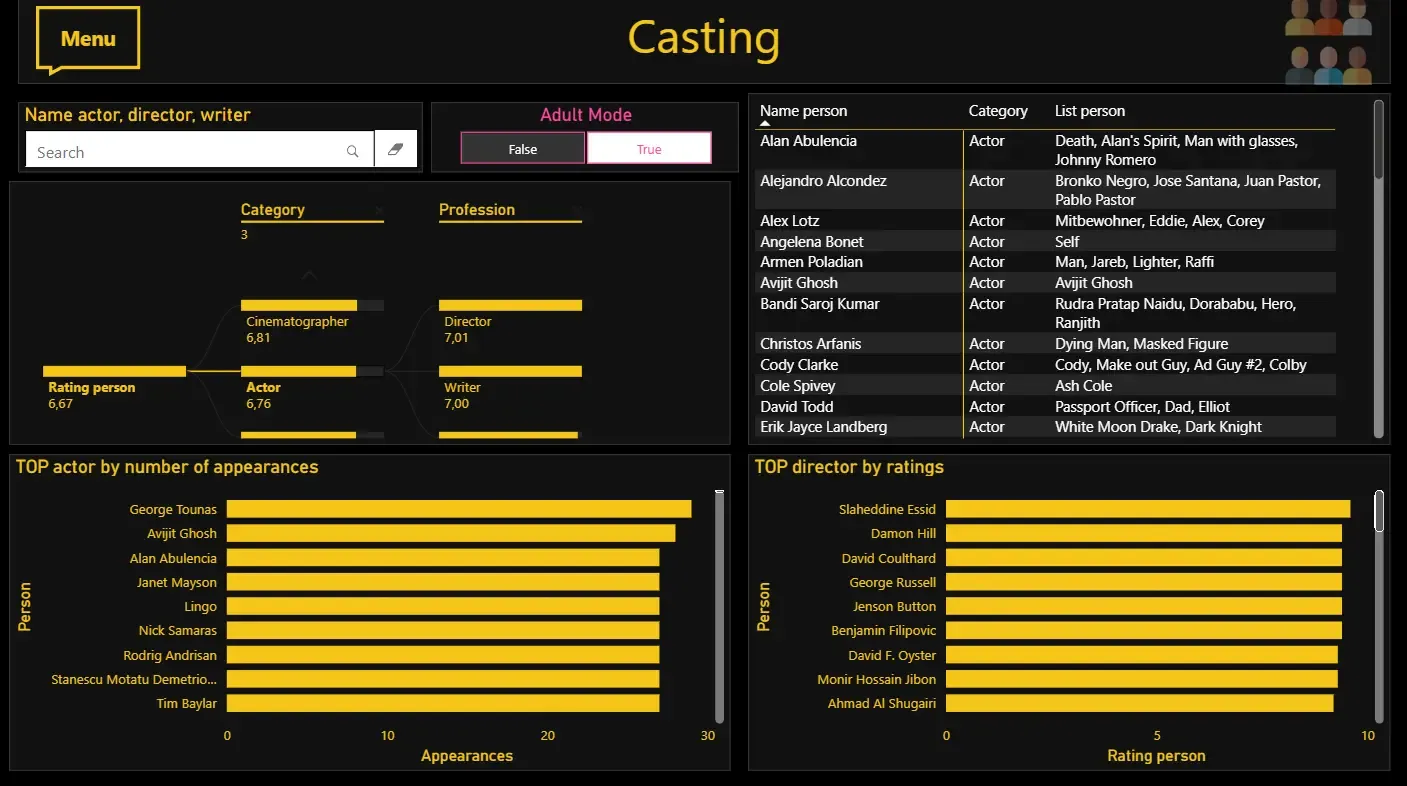
Analyse des castings. 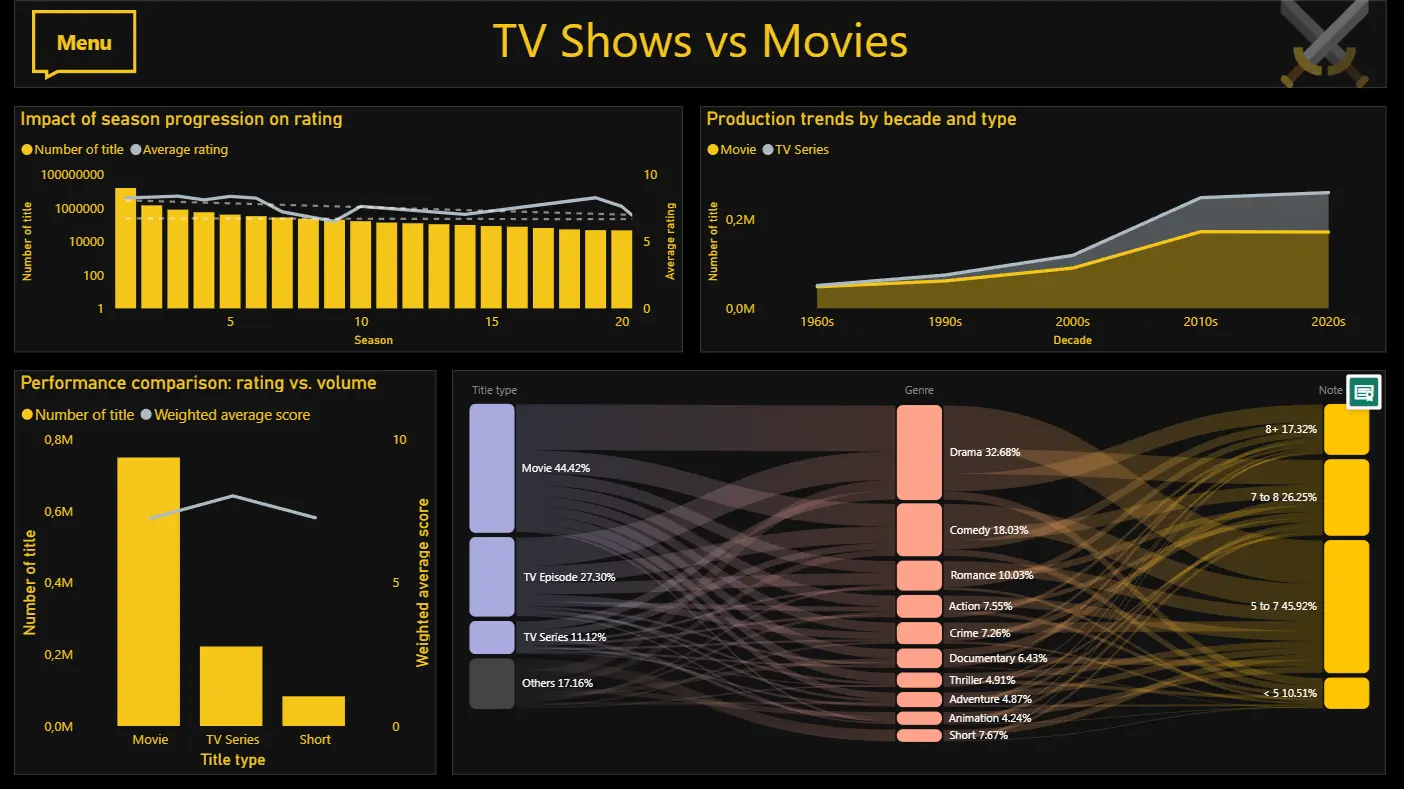
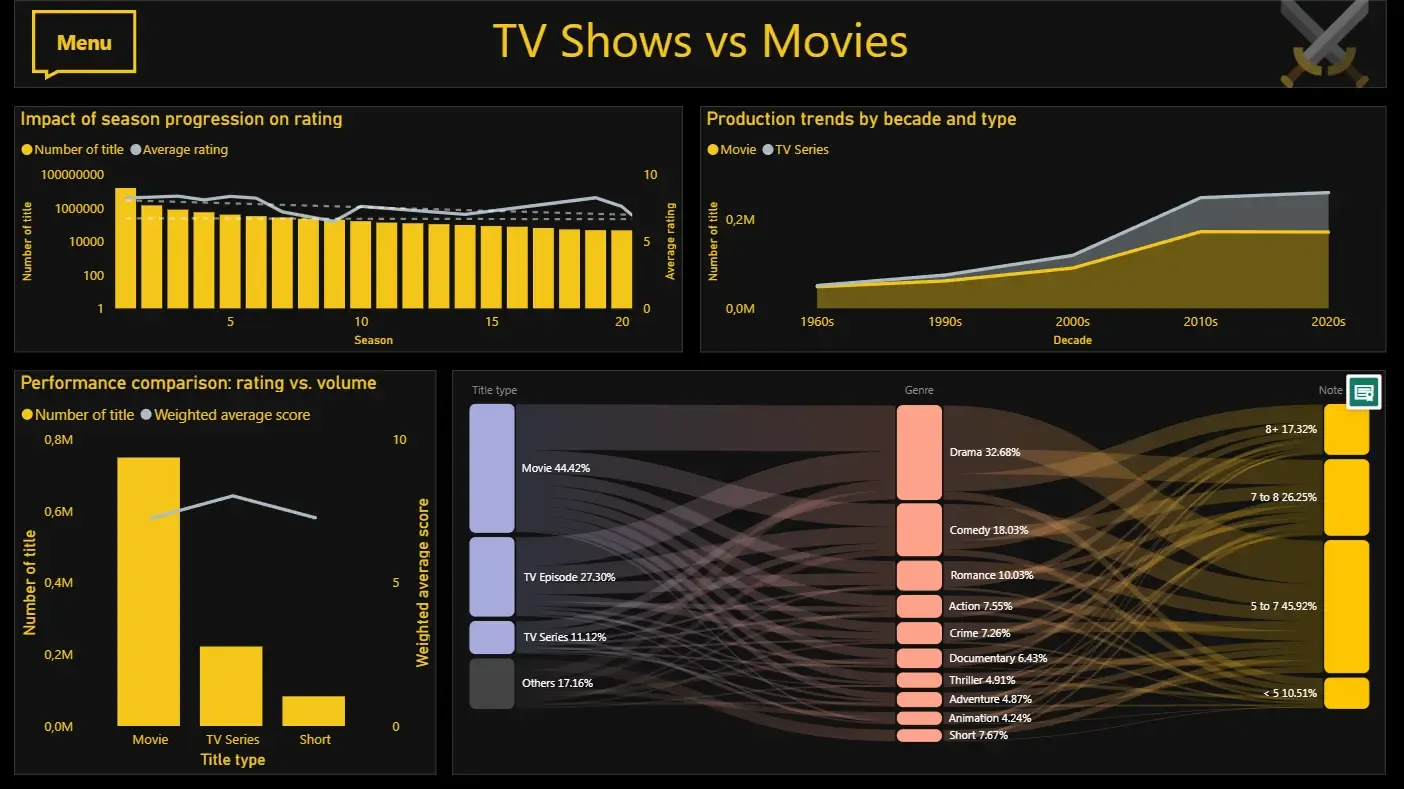
Séries et films comparés, jusqu’au diagramme de Sankey. 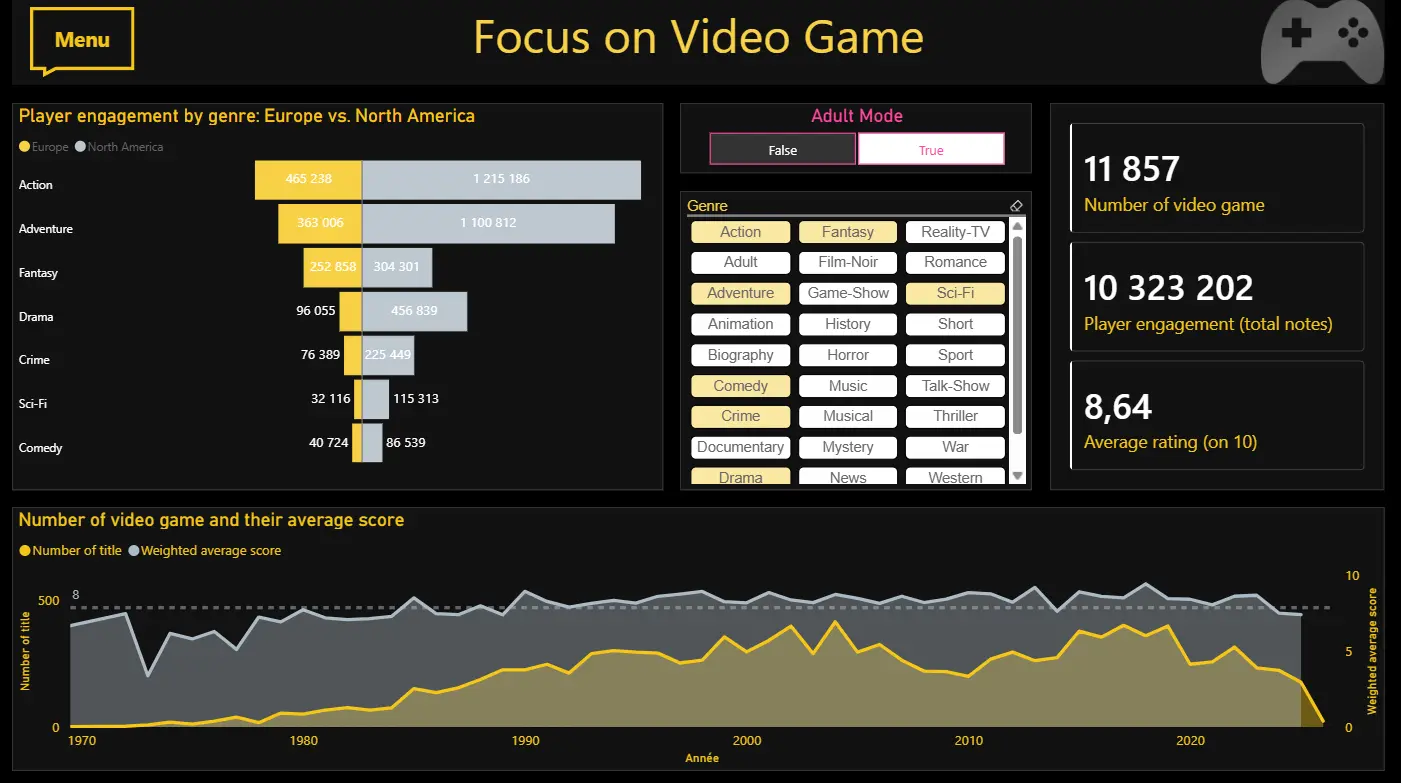
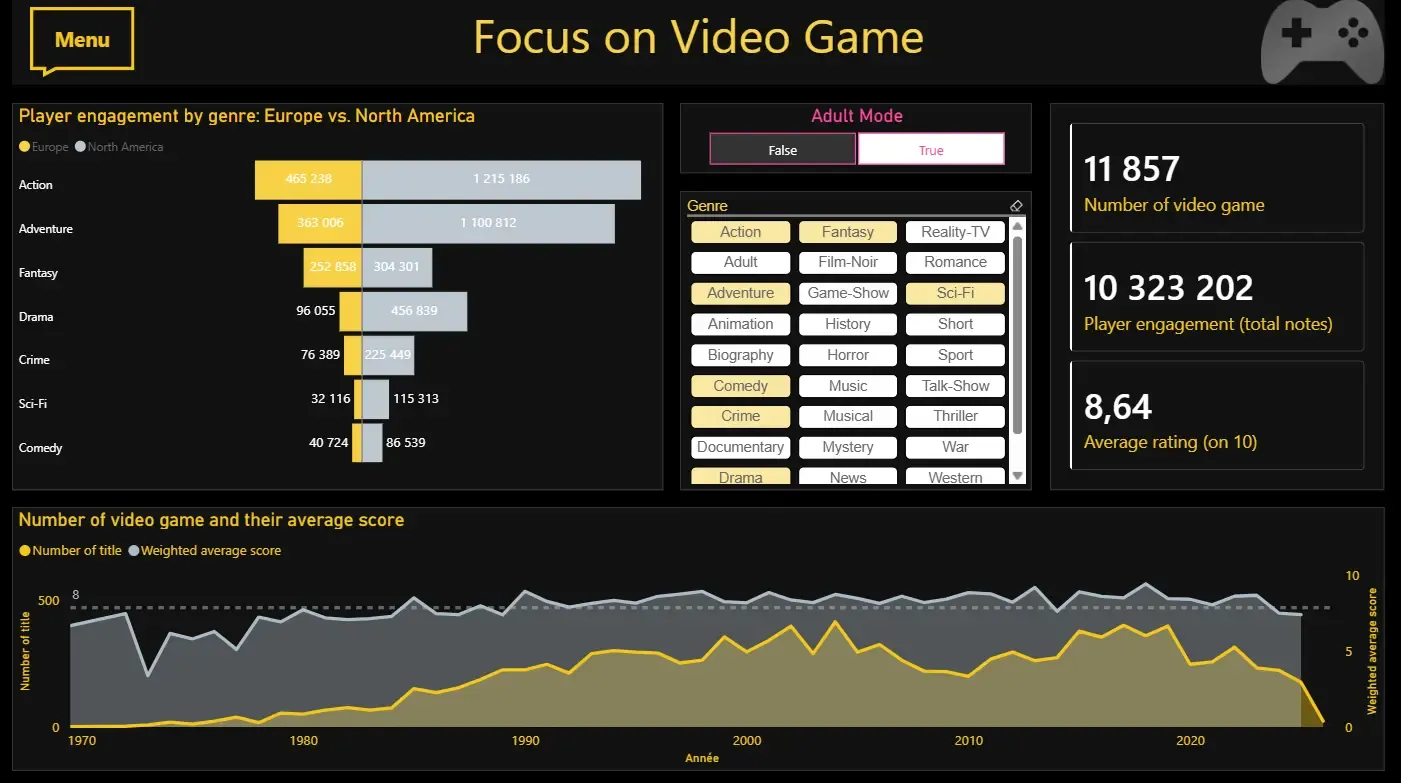
Focus sur les jeux vidéo. 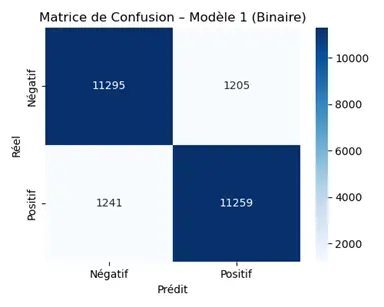
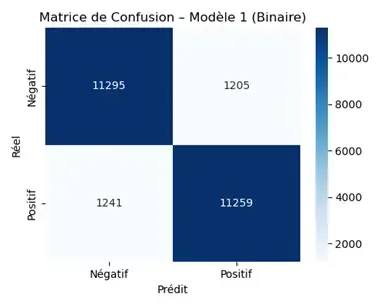
Modèle 1, polarité positive ou négative. 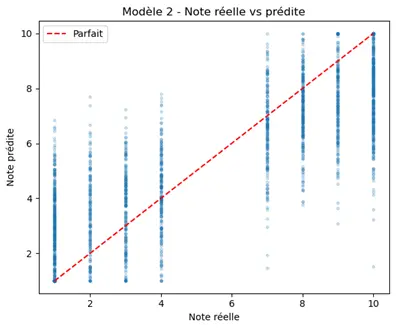
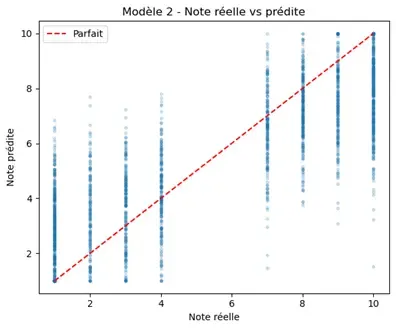
Modèle 2, note réelle et note prédite sur 10. 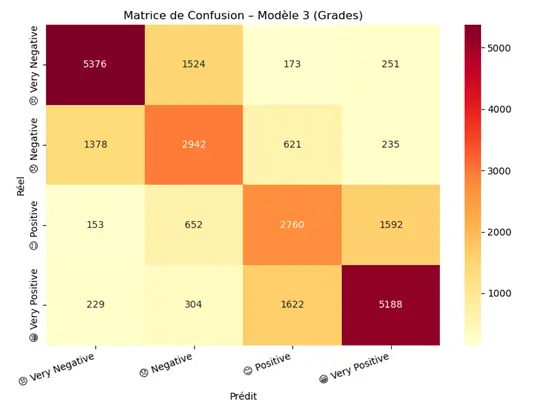
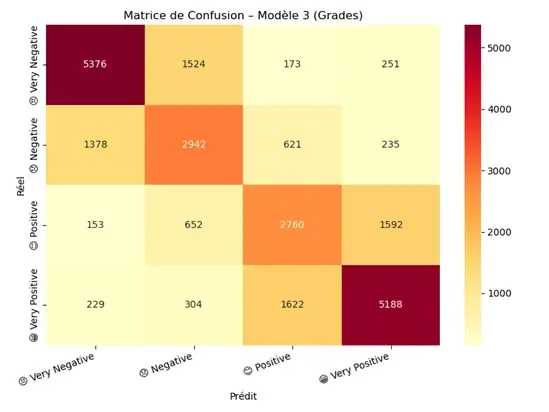
Modèle 3, classification par grades.
Chiffres et faits
- 7 fichiers TSV en entrée
- Plus de 12 Go
- traitées par l’ETL, en 25 minutes
- 222 M de lignes
- modèles OLTP et OLAP
- 12 + 12 tables
- requête de jointure après indexation
- De 62 à 7 ms
- d’accuracy sur la polarité, sur 25 000 critiques de test
- 90,2 %
- sur la note sur 10, avec un R² de 0,657
- MAE de 1,61
- d’accuracy sur les grades, la classe Mixed étant attribuée par règle
- 65 %
- rapport Power BI OLAP et ses info-bulles
- 5 + 3 pages
Ce que j’en retiens
Les difficultés et les apprentissages sont venus du management du projet et de l’initialisation du cahier des charges.